Agent Systems
我们距离Jarvis还有多远?
从 AI Agent 到真正的常驻智能体。
图 1|Tony Stark 与 J.A.R.V.I.S.。来源:Business Insider;© Marvel Studios。
为什么 AI 已经很强,却仍没有Jarvis?
《钢铁侠》中的Jarvis像一个始终在场的 Agent:用户需要时可以响应,能结合上下文理解正在处理的事情,也会留意环境变化,并在合适的时候协助。这里讨论的是电影塑造的助手形象,不借用具体桥段来推断它具备什么技术能力。
今天的 Agent 已经能读邮件、写代码、操作浏览器,也能把复杂指令拆成多步工具调用。只看一次任务,它们有时像一个能干的数字同事。但一次任务结束后,系统是否还记得哪些事情没完成?用户没有发来新消息时,它能否留意外部变化?它发现变化后,又能否判断应当提醒、询问、行动,还是保持安静?这些问题决定了一个 Agent 能否从“能做事”走向“长期提供服务”。
何为“常驻”?
提到常驻 Agent,我们可能首先想到的是一个能够在后台持续工作的 AI 助手。一般来说,“后台执行”“长时间运行”“持久记忆”“主动服务”的Agent都被认为是常驻的。不过这些显然是几件不同的事。
比如,一个 Agent 可以在电脑关机后继续完成任务,但任务结束后就不再跟进;另一个 Agent 可能记得你几个月前说过的话,却仍然需要你主动发起对话;还有一些 Agent 可以定时检查邮件、监测股票价格,并在满足预设条件时通知用户。这些系统都多少有些“常驻”的味道,但距离我们想象中的Jarvis,似乎还有些区别。
那么,学术界是怎么理解“常驻”的呢?
Always-On Agents Survey 给出了一个比较宽泛的定义:常驻并不要求模型始终运行,关键在于 Agent 能否将过去的信息保留下来,并用于之后的交互和行动。而且,需要保存的远不止聊天记录和用户偏好,还可能包括尚未完成的任务、此前获得的权限,以及已经执行过的操作等。这也带来了新的麻烦:如果用户后来改变了主意,Agent 能否及时更新自己的记忆?如果某项授权已经失效,它还会不会继续按照旧指令办事?这些都是长期运行的助手不得不面对的问题。
这篇综述主要从跨会话持久状态及其管理出发,关注长程任务调度中的记忆管理,然而能够记住过去,似乎仍然不足以成为Jarvis。我们还希望它能自己发现需要处理的事情。Proactive Service Agents Survey 关注的就是这种主动性:Agent 能否根据用户的行为和环境变化,推测用户可能需要什么帮助,并决定何时、以何种方式介入。例如,每天早上八点按要求提醒用户开会,只是在执行预设任务;如果 Agent 发现用户明天要汇报,而 PPT 里的实验数据尚未更新,主动询问是否需要协助,就更接近这里所说的主动服务了。
当然,主动性也并非越强越好。一个整天弹窗、动不动就想替用户做决定的助手,恐怕很快就会被关掉(而且这也会很烧钱)。什么时候该提醒、什么时候该询问、什么时候干脆保持安静,同样需要判断。
我们这篇博客会更关注将 Persistent(持久状态)、Monitoring(持续监测)与 Proactivity(主动服务) 结合起来的 Agent。这里并不是要给“常驻”下一个新的标准定义,而是希望借此讨论一种更Jarvis-like的智能体:它能够长期跟进用户的事务,留意相关变化,并在合适的时候主动提供帮助。
现有产品到Jarvis-like的距离
Spark 和 Dots:如今的常驻 Agent 做到了哪一步?
近来,Google 的 Gemini Spark 和 OpenAI 的 Dots 都开始以“Always-on Agent”为卖点,让 AI 从聊天窗口走向长期的后台服务。那么,这些产品是否已经接近我们想象中的Jarvis了?
先看 Gemini Spark。它最大的特点是可以在云端持续处理任务,即使用户关掉电脑也不受影响。比如,收到航班确认邮件后自动更新行程、定期检查球场空位、发现订阅涨价后发送提醒等。听起来已经有些Jarvis的味道了,不过这些任务大多仍需要用户提前设定目标或触发条件,Agent 主要负责后续的监测与执行。
OpenAI Dots 则更进一步。除了后台执行,它还可以利用长期记忆和工作笔记,跨越不同对话持续跟进任务。例如,用户可以让它关注某个 Slack 频道,追踪项目进展;它也能结合已连接的信息主动研究,并提出下一步建议。相比单纯的定时任务,Dots 已经开始展现一定的自主性,但目前公开的功能描述仍然以用户交办的责任和授权的信息范围为基础。
两者的主要能力可以简单整理如下:
| 能力 | Gemini Spark | OpenAI Dots |
|---|---|---|
| 后台持续执行 | 支持云端任务 | 支持云端任务与工作环境 |
| 跨会话记忆 | 可利用 Gemini 历史对话记忆和个性化信息;支持保存、暂停及恢复任务 | 可利用 ChatGPT Memory 和自身保存的工作笔记,持续跟进跨会话任务 |
| 环境监测 | 定时检查、邮件事件触发等 | 可监测指定频道和事件 |
| 主动发现需求 | 以用户设定的目标和条件为主 | 能主动研究已连接信息并提出建议 |
| 行动权限 | 高风险操作需确认 | 按授权范围执行,部分操作需审批 |
表 1|根据 Google 官方公告与 OpenAI Dots 官方文档整理。
可以看到,后台执行、长期记忆、事件监测等能力已经开始走向产品化,部分系统甚至能够主动寻找值得关注的信息。 不过,距离我们期望的那种能够持续理解用户的工作与生活、自主发现潜在需求,并在恰当时候提供帮助的Jarvis式 Agent,仍然有不少问题有待解决。
常驻服务如何运转
前面提到的 Spark 和 Dots 已经能在后台持续处理任务,那么,如果我们希望 Agent 更进一步,能够长期关注用户的工作状态,并在需要时主动提供帮助,它应该如何运转呢?
不妨想象这样一个场景:你让 Agent 帮忙关注一个正在推进的科研项目。几天后,新的实验结果出来了,与你之前汇报中的数据不一致。理想情况下,Agent 应该能发现这一变化,回想起之前的汇报内容,判断是否有必要提醒你,并在得到允许后协助更新文档。即使你暂时没有回复,它也应该知道这件事还没有处理完,而不是在当前对话结束后就不了了之。
要实现这样的过程,大致需要如下所述的几个环节相互配合:
- 感知环境变化:通过应用通知、定时检查等方式获取新信息,而不必让大模型时刻盯着屏幕。
- 维护长期状态:记住项目进度、之前做过的事情,以及用户的偏好和授权。当情况发生变化时,及时更新这些信息。
- 判断何时介入:发现变化后,决定是暂时等待、提醒用户、询问意见,还是直接处理已经获得授权的任务。
- 执行具体操作:需要行动时调用相应工具,例如查看文件、整理数据或修改文档,并确保操作没有超出授权范围。
- 跟进结果:记录事情是否真正完成。如果任务失败、用户改变主意,或者又出现新的变化,就调整后续安排。
这几个环节不断循环,Agent 才能在不同任务和会话之间持续提供服务。而且它们未必需要由同一个大模型完成:环境监测、定时唤醒、状态存储和权限检查都可以交给普通软件组件,只有遇到需要理解上下文、判断用户意图或规划行动的问题时,才调用更强的模型。
显然常驻 Agent 没必要让大模型 24 小时不停地思考。更合理的方式是让系统平时保持必要的监测和状态维护,在出现值得处理的事情时唤醒 Agent,处理结束后再继续等待。这既有利于控制运行成本,也让长期服务真正具备可持续性。
相关研究进展
围绕常驻 Agent,学术界已经开展了不少研究,包括长期记忆、主动发现需求、环境监测和长周期任务等。下面挑选几项有代表性的工作,看看目前的 Agent 在这些方面究竟做到了什么,又还有哪些问题没有解决。
长期记忆的管理与调度机制
长期记忆(Agent Memory)已经是 Agent 领域相当热门的研究方向,相关工作也比较丰富。例如,LongMemEval 主要考察 Agent 能否从过去的多轮对话中准确找回信息;Mem2ActBench 则更进一步,研究 Agent 能否利用此前积累的用户偏好和约束,正确完成后续的工具调用;Memora 关注的则是记忆的更新与遗忘,例如用户已经改变了计划,Agent 是否还会错误地沿用过去的信息。
总体来看,Agent Memory 的研究已经从简单的信息存储与检索,逐渐扩展到记忆驱动的行动、动态更新和遗忘等问题。不过,对于常驻 Agent 来说,长期记忆的难点还在于如何在持续运行的过程中维护可靠的状态:哪些信息应该保留,哪些已经失效,以及如何避免错误记忆影响之后的操作。毕竟,一个聊天助手记错事情,可能只是答错一个问题;但一个能够长期自主行动的 Agent,可能会把这次错误带到后续的一连串任务中。
如何让 Agent 主动发现需求
相比长期记忆,Agent 的主动性是一个更有意思的问题。我觉得,主动性可能是常驻 Agent 走向大众的一大难关,另一个绕不开的问题则是隐私与授权。如今的 Agent 已经能完成不少复杂任务,但大多数时候,我们仍然需要先告诉它要做什么。那么,Agent 有没有可能根据我们的行为和周围的变化,自己发现值得帮忙的事情?
这里需要区分两种情况。比如,我们让 Agent“有新邮件就提醒我”,它只需要监测一个预先设定的条件;但如果 Agent 发现你收到了一封航班改期邮件,又注意到日历里有一场重要会议,于是主动询问是否需要调整行程,那就涉及对潜在需求的推断了。而且,发现可能需要帮助还不够,它还得判断现在是否适合打扰用户。
ICLR 2025 的 PROACTIVE AGENT 就研究了这一问题。研究者构建了 ProactiveBench,让 Agent 根据编程、写作和日常活动中的事件序列,判断用户是否可能需要帮助。实验中,经过微调的 Qwen2-7B 在主动帮助任务上取得了 66.47% 的 F1。不过,论文也发现模型容易过度热心:即使用户并不需要帮助,它也可能主动提出建议。对于真正长期陪伴用户的助手,这类误报显然不能忽视。
另一项工作 PARE(Proactive Agent Research Environment) 则更进一步,把主动决策放进了具有真实应用交互逻辑的模拟环境。它设计了 143 个涉及通信、日程、办公等场景的任务,由模拟用户在应用中操作,Agent 则需要观察这些行为、推断目标,并在合适的时候介入。实验中,表现较好的 Gemini 3 Flash 和 Claude 4.5 Sonnet,任务成功率也分别只有 42.1% 和 42.0%。
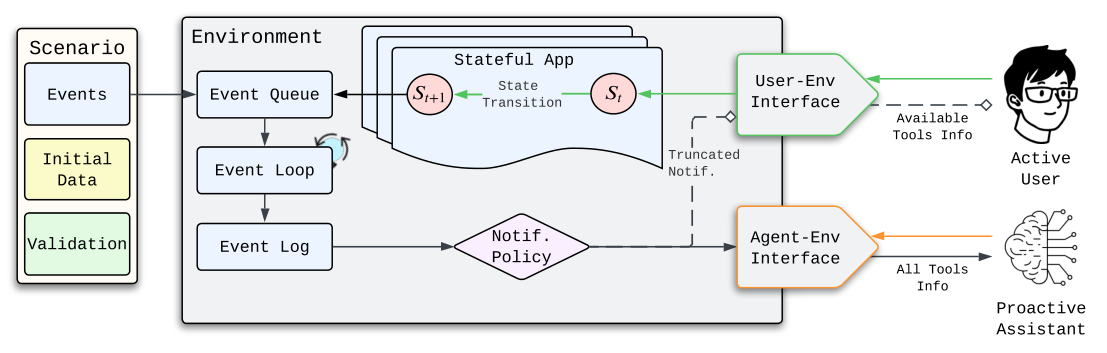
图 2|PARE 评测环境与交互接口(Figure 1)。来源:Nathani 等,PARE,CC BY 4.0。
这些研究说明,Agent 已经可以通过训练学习主动发现需求,也有了相应的 Benchmark 来检验这种能力。但目前的评测仍以有限的事件数据或模拟用户为主,距离真正长期融入日常生活还有不小的差距。尤其是一个很难通过离线测试回答的问题:**用户究竟希望 AI 多主动?**同样一个提醒,有人可能觉得贴心,有人却觉得打扰。如何理解不同用户的习惯,并在长期交互中逐渐把握介入的分寸,恐怕也是走向Jarvis-like必须解决的问题。
长期任务中的“我看,我再看”
前面讨论的是 Agent 能否主动发现用户没有提出的需求。但即使用户已经明确交代了任务,要让 Agent 长期跟进一件事,也没有那么简单。比如,你让它持续关注某个会议的投稿状态,等结果公布后通知你。它应该多久检查一次?如果每隔几秒就调用大模型查询,成本显然难以接受;但检查得太少,又可能错过重要变化。
SentinelBench 就研究了这类长期监测问题。它构建了 100 个模拟网页监测任务,让 Agent 等待指定事件发生,并比较不同等待机制的表现。在一项最长持续 40 分钟的实验中,使用 GPT-5.4 时,条件等待工具 wait_for 的任务成功率达到 69%,中位 API 成本为 0.48 美元;采用固定休眠方式的 sleep 则分别为 56% 和 4.65 美元。不过,前者的响应延迟也稍高一些(54.8 秒对 38.9 秒)。可见,即使模型本身不变,如何安排等待和唤醒,也会显著影响 Agent 的运行成本与实际表现。
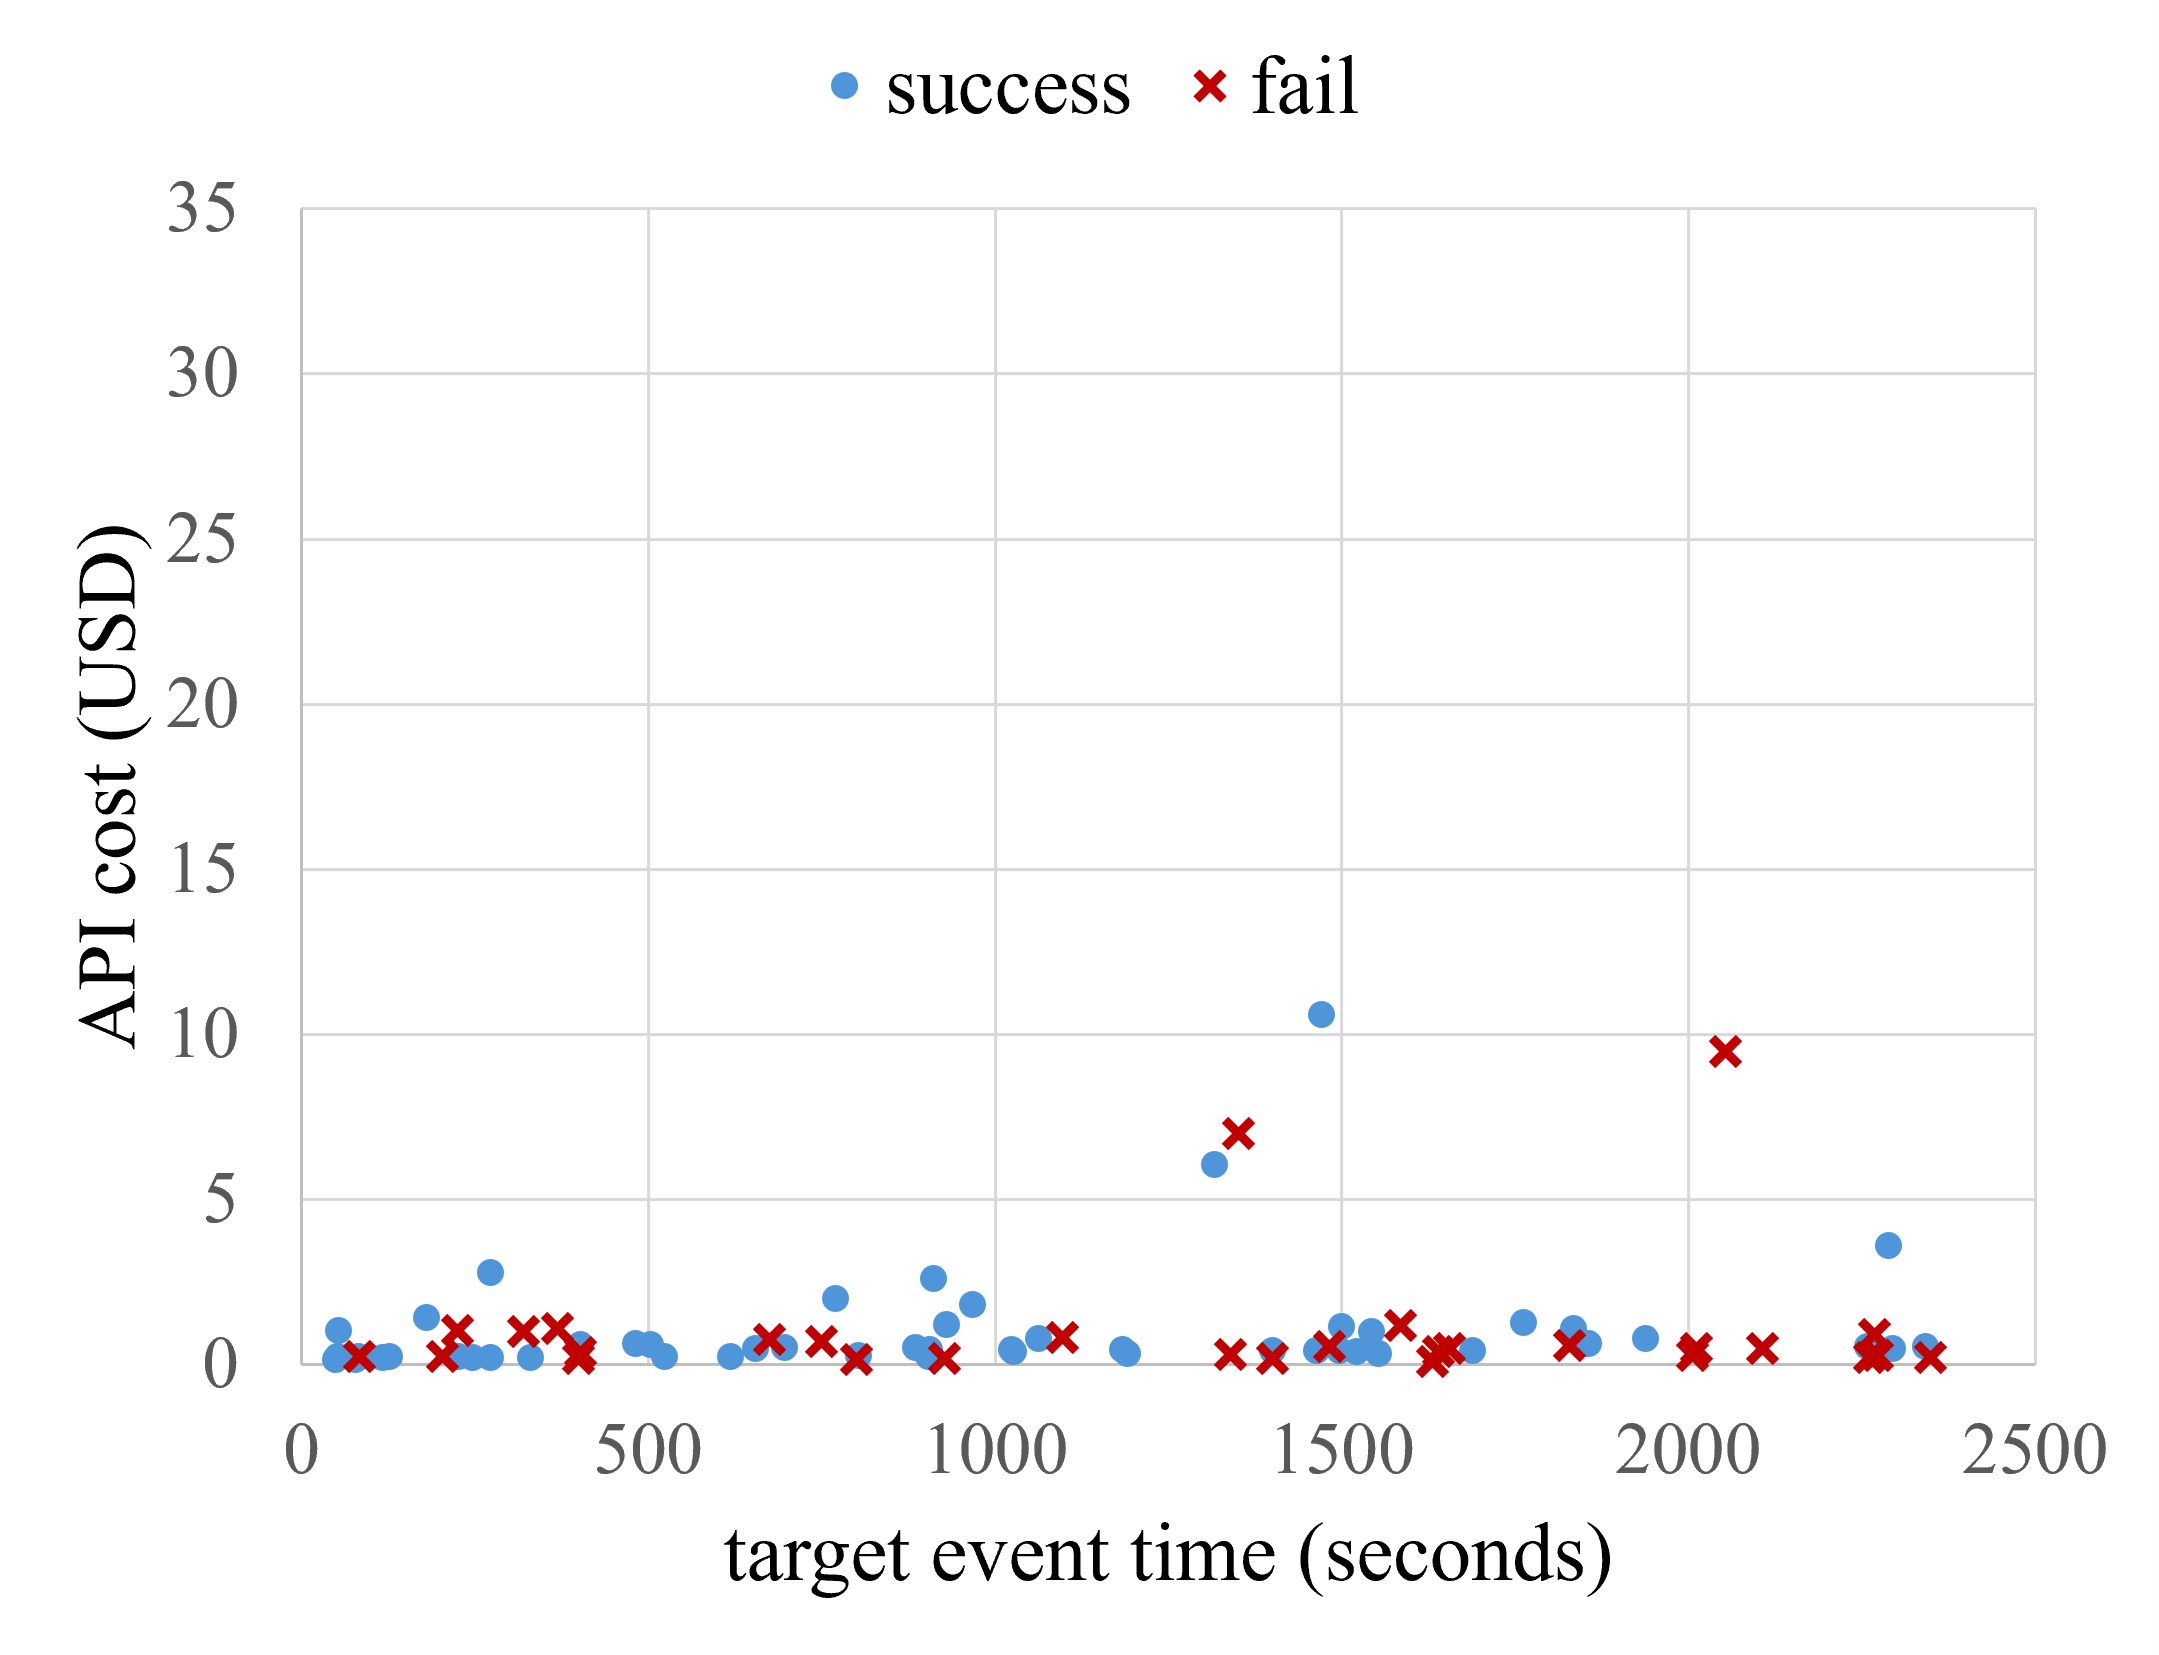
wait_for。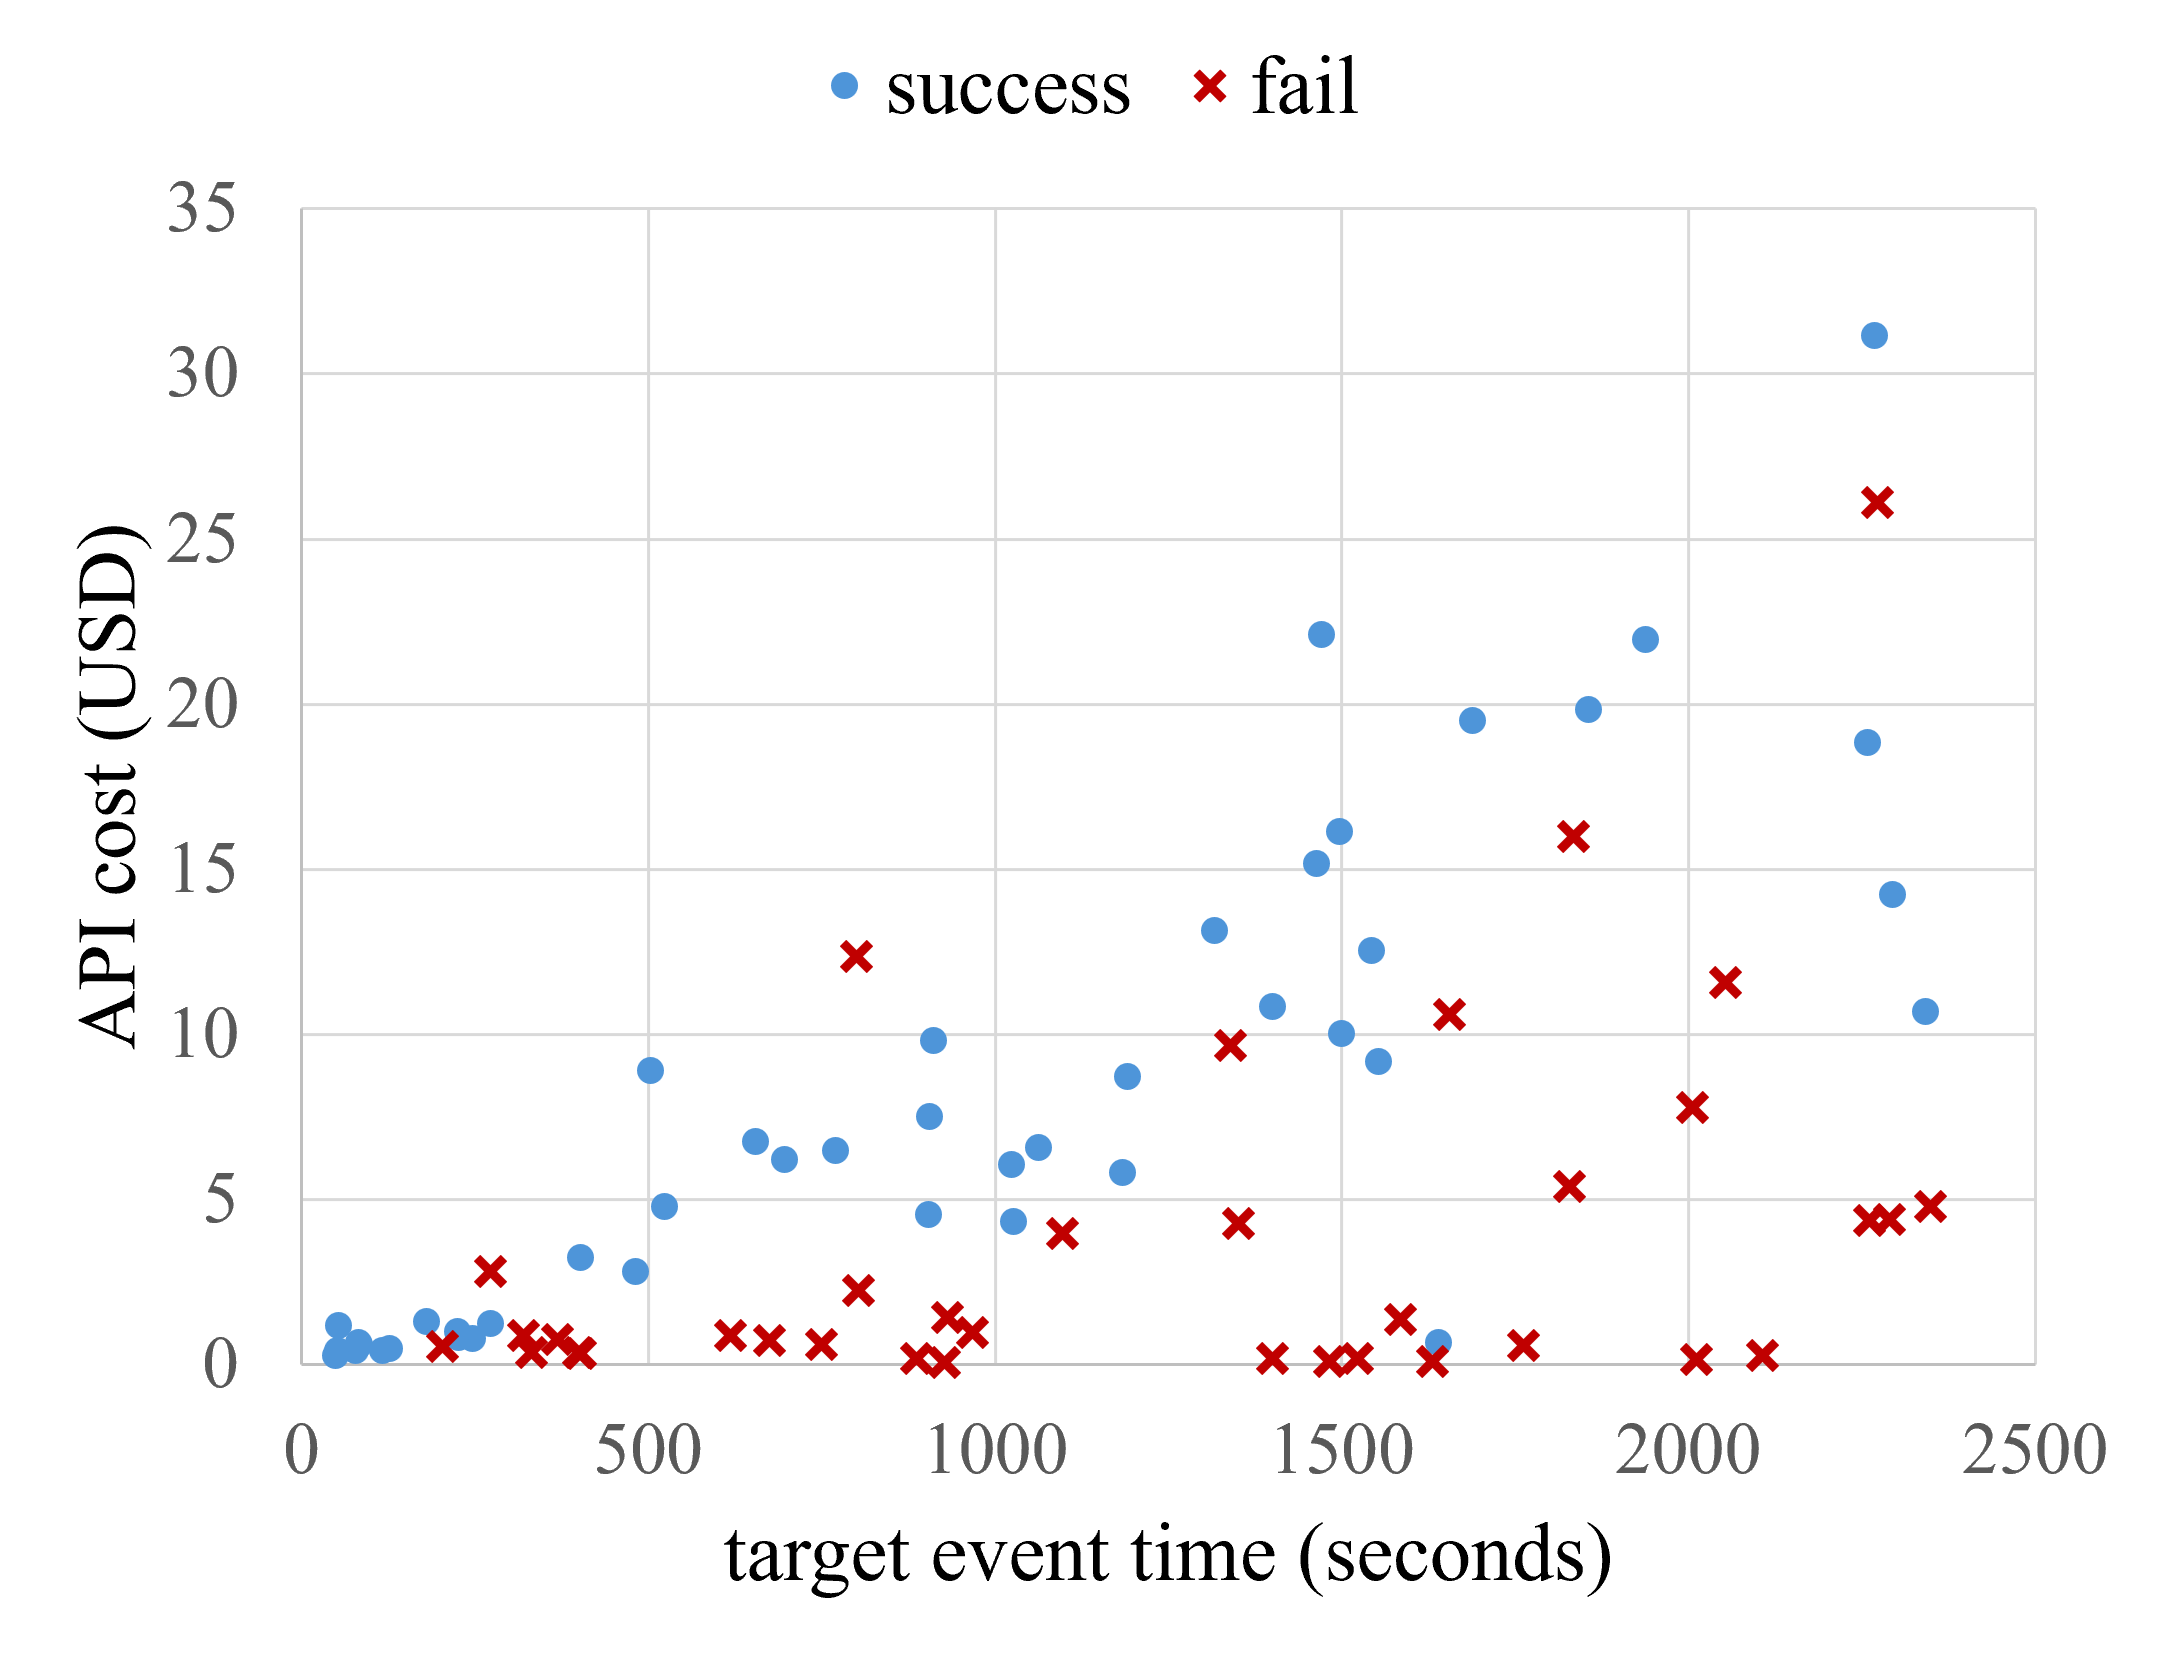
sleep。图 3|SentinelBench 的 wait_for 与 sleep 成本对照(Figure 7)。来源:Kunzler Maldaner 等,SentinelBench,CC BY 4.0。
但如果任务不是持续几十分钟,而是几周甚至几个月呢?这时需要考虑的就不只有监测效率了。用户可能临时改变计划,外部环境可能悄悄发生变化,而 Agent 还得记住之前的各种限制,确保后续行动不会自相矛盾。
VibeLifeBench 尝试研究这个问题。它构建了 200 个跨越多周的模拟生活任务,涉及旅行、财务、职业等场景,期间会发生数千次环境事件,其中还有 1,483 次不会主动通知 Agent 的“静默变化”,需要系统自行发现并调整计划。
实验结果并不乐观。七个受测模型中,表现最好的 Claude Opus 5 在基准综合指标 avg@3 上也仅取得 32.5 分。而且,随着任务逐渐推进,所有模型的阶段检查通过率都有所下降。例如,Claude Opus 5 从任务时间线前段的 52.0% 下降到了末段的 37.7%。
| 模型 | 时间线前段 | 时间线末段 |
|---|---|---|
| Claude Opus 5 | 52.0% | 37.7% |
| GPT-5.5 | 47.4% | 33.1% |
| Claude Opus 4.8 | 46.8% | 34.6% |
| GLM-5.2 | 45.9% | 32.3% |
| Gemini 3.5 Flash | 42.5% | 32.6% |
| DeepSeek-V4-Pro | 42.6% | 27.4% |
| Kimi-K2.6 | 42.2% | 27.1% |
表 2|VibeLifeBench 中各模型在任务时间线前、后三分之一的阶段检查通过率。数据来自 原论文,并非最终任务成功率。
当然,这些结果来自模拟环境,不能直接代表真实生活中的服务表现。但它们揭示了一个很现实的问题:完成一次任务已经不容易,持续几周把同一件事做好,可能更加困难。 Agent 既要及时发现变化,也要把变化正确地反映到计划和记忆中,并在之后的行动中继续遵守已有约束。
从这个角度看,Jarvis-like Agent 面临的挑战,不仅是能否理解用户、执行任务,还包括能否随着时间推移,始终保持对事情进展的正确理解。
距离 Jarvis-like Agent,还差什么?
从单项能力到长期可靠的服务
回顾前面的研究,我们已经能看到不少进展:Agent 可以利用长期记忆完成任务,可以从用户活动中推测潜在需求,也可以在后台监测事件、持续跟进计划。但这些能力目前大多还是分别研究和评测的,真正把它们结合起来,让一个 Agent 长期、稳定地为用户服务,仍然有不少困难。
举个例子,一个 Agent 发现了新的实验结果,判断你可能需要更新组会 PPT,于是主动提出帮助。看起来很简单,但它还需要知道哪份 PPT 是最新版本、哪些结果已经被修改、你是否允许它编辑文件,以及这次修改会不会影响其他文档。如果你后来取消了组会,或者实验结果再次变化,它还得及时调整原来的计划。
这也是 Jarvis-like Agent 与普通任务型 Agent 的一个重要区别:我们希望它长期理解并跟进一件事,而不只是每次收到指令后完成一个孤立的任务。 随着时间推移,用户的目标、外部环境和已有约束都可能发生变化。如何让系统持续跟上这些变化,并在出现错误时及时纠正,是比单次任务成功率更难衡量的问题。
长期运行还有哪些现实困难?
首先是运行成本与响应速度。常驻不意味着让大模型全天候运行,但环境监测、状态更新和必要的推理仍然需要消耗资源。检查得太频繁会增加成本,间隔太长又可能错过重要事件。对于不同任务,如何安排合理的监测和唤醒机制,是实际部署时绕不开的问题。
其次是长期记忆与状态管理。用户的偏好可能改变,原来的计划可能取消,某些信息也会逐渐过时。Agent 不仅需要记住过去,还得知道哪些记忆已经失效,并确保修改能够同步到正在执行的任务中。否则,保存得越多,反而可能积累越多错误。
主动服务的分寸同样难以把握。Agent 即使正确猜到了用户的需求,也不意味着此刻就应该打扰用户,更不意味着可以直接替用户作决定。它需要逐渐了解用户的习惯,判断哪些事情值得提醒、哪些需要征求意见,以及什么时候保持安静更合适。这类能力很难只靠模拟用户和离线 Benchmark 完整评估。
此外,长期自主行动也带来了更复杂的权限与安全问题。例如,用户授权 Agent 读取邮件,并不代表允许它发送邮件;过去给予的权限,也不一定适用于之后的所有任务。当系统能够跨越多个应用自主操作时,如何限制权限、记录操作并允许用户随时介入,就显得格外重要。
最后还有容易被忽视的错误恢复能力。一次工具调用失败,Agent 能否确认操作究竟有没有完成?如果任务执行到一半,用户突然改变计划,系统能否安全地停止或调整?对于运行几分钟的 Agent,这些问题也许只是偶发异常;但对于一个要持续服务几周甚至几个月的系统,小错误就有可能逐渐累积,最终影响整个任务。
因此,我认为 Jarvis-like Agent 下一阶段的重要挑战,可能并不只是让模型变得更聪明,而是如何让记忆、感知、主动决策与工具执行真正组成一个长期可靠的系统。现有研究已经在逐步解决其中的各个问题,但距离把这些能力稳定地结合起来,还有一段路要走。
我们距离 Jarvis 还有多远?
回到最初的问题,我们距离 Jarvis 还有多远?从前面的研究来看,答案恐怕仍然是不近。但我对这个方向的未来却相当乐观,甚至愿意做一个稍显激进的判断:常驻 Agent 很可能会成为下一阶段 AI Agent 领域的重要热点,甚至是未来几年值得重点押注的研究方向之一。
这种预感并非空穴来风。从 xAI 的 Grok Bot、OpenAI 的 Dots 等产品相继亮相,到国内社区围绕常驻 Agent 的讨论与探索,我们已经能感受到业界正在认真考虑一件事:如何让 AI 从一个随用随开的工具,逐渐变成能够长期参与我们工作与生活的助手。
当然,目前不少产品仍然选择为 Agent 提供独立的云端工作空间。这种设计有明显优势:环境相对隔离,方便管理权限,也更容易让 Agent 独立执行长时间任务。但我认为,人与 Agent 在同一个 Workspace 中实时协作,同样是一片值得探索的空间。 现实中的工作往往需要人和 AI 共同完成:我们可能一边编辑文档,一边让 Agent 整理资料;也可能有多个 Agent 同时操作同一个项目。如何避免操作冲突、协调共享状态、理解彼此正在进行的工作,以至于让 Agent 在不打断人的情况下自然接手任务,这些都可能成为很有意思的研究问题。
更让我兴奋的是,回头看过去一段时间的学术热点,似乎有不少方向正在向这里汇合。Agent Memory 让模型能够保留长期上下文,流式多模态理解使持续观察用户和环境成为可能,Decision Model/Script范式的主动决策让 Agent 开始尝试发现尚未明说的需求(前段时间很火的Jev或许也可以插一脚进来),而长程任务、工具使用和多智能体协作研究,则在不断拓展它实际能够完成的事情。它们当然有各自独立的研究价值,但当我们试着将这些能力放到同一个系统中时,一个更加完整的 Jarvis-like Agent 似乎也逐渐有了轮廓。这简直是我们漂泊的终点。
相关论文和产品已经陆续出现,常驻 Agent 甚至正在成为一个越来越拥挤的概念。但从长期记忆的可靠性,到更细粒度的多模态环境感知,再到人与 Agent 的共享工作空间、主动介入时机和长周期评测,仍然有大量问题没有得到充分解决,有太多值得开垦与耕耘的空间。可以说这算是半个蓝海。
也许这种判断带有一些个人的乐观,但我确实有种感觉:过去那些看似分散、各自寻找突破口的 Agent 研究方向,正在逐渐汇入同一条河流。我们追求的似乎不再只是一个能完成更多任务的模型,而是一个真正能够长期存在于数字生活中、理解我们的处境,并与我们共同工作的智能体。
至于 Jarvis-like Agent 最终会以什么形态出现,我还不敢预测。但如果说 AI Agent 的下一站值得期待什么,我想,一个真正能够与人长期共处、共同工作的智能体,会是我最愿意押注的答案之一。
参考文献与资料
正文重点讨论
- Always-On Agents: A Survey of Persistent Memory, State, and Governance in LLM Agents, 2026.
- Packer et al., MemGPT: Towards LLMs as Operating Systems, 2023.
- Wu et al., LongMemEval: Benchmarking Chat Assistants on Long-Term Interactive Memory, 2024.
- Uddin et al., From Recall to Forgetting: Benchmarking Long-Term Memory for Personalized Agents(Memora), 2026.
- Kunzler Maldaner et al., SentinelBench: A Benchmark for Long-Running Monitoring Agents, 2026.
- Xiaohongshu Dots Studio and Evolvent AI, VibeLifeBench: Can Your Life Agent Be Proactive and Persistent in a Living World?, 2026.
- Dou et al., Agents in the Large: Perception-Centered Architecture for Persistent Agents(Pera), 2026.
- PROACTIVE AGENT: Shifting LLM Agents from Reactive Responses to Active Assistance, ICLR 2025.
- Nathani et al., Proactive Agent Research Environment: Simulating Active Users to Evaluate Proactive Assistants(PARE), 2026.
补充阅读
- Xu et al., A-MEM: Agentic Memory for LLM Agents, 2025.
- Mem2ActBench: A Benchmark for Evaluating Long-Term Memory Utilization in Task-Oriented Autonomous Agents, 2026.
- Froger et al., Gaia2: Benchmarking LLM Agents on Dynamic and Asynchronous Environments, 2026.
- Tang et al., Proactive Service Agents: A Unified Decision Framework, Methods, and Evaluation, 2026.
- Deng et al., Towards Human-centered Proactive Conversational Agents, SIGIR 2024.
- Microsoft Research, Tell me when: Building agents that can wait, monitor, and act, 2025.
- Google, Introducing Gemini Spark, 2026;OpenAI, Meet dots, 2026.